Агенты сначала считают аналитику
В 2 часа ночи срабатывает алерт по выручке. Дежурный ops-агент берёт его в работу и получает прямой вопрос от инженера, которому отчитывается: «Найди инциденты за последние две недели, связанные с отказами GPU, из-за которых потеря выручки превысила $1M, и включи похожие исторические случаи».
Прежде чем рассуждать об исправлении, агент должен на это ответить. Ответ по большей части аналитическая задача. Агент отфильтровывает инциденты за последние две недели, сопоставляет текст fault-логов с отказами GPU, агрегирует влияние на выручку выше $1M, а затем ранжирует прошлые инциденты по семантической близости. Четыре из пяти шагов — фильтрация, временные окна и агрегация. Один шаг — векторный поиск.
Большинство команд строит data layer для агентов в порядке, обратном тому, как агенты им пользуются. Они начинают с семантического retrieval: векторные базы, RAG-фреймворки, оркестрация workflow. Эта работа настоящая, и production-агентам она нужна. Недостроенным остаётся слой, в который агент попадает первым: real-time аналитика по конкретным бизнес-фактам.
Эти факты конкретны и операционны: заказы, записи пользователей, транзакции, остатки, алерты. Агенту клиентского сервиса нужны текущий статус заказа, обновления доставки и право на возврат. Агенту бизнес-аналитики нужны живая выручка, конверсии и сигналы аномалий. Ops-агенту нужно знать, какие алерты срабатывают и на что они влияют. Каждая задача — более автоматизированная версия той real-time аналитики, которую уже запускает человек-оператор.
Агенты давят на этот слой сильнее, чем люди. Они делают много запросов на одну задачу, ждут свежие данные и работают параллельно в тысячах сессий. Real-time ingestion, низкая задержка, много одновременных запросов и единый язык запросов становятся базовыми требованиями. Это определяющие возможности систем real-time аналитики вроде Apache Doris.
Что меняет agentic-нагрузка
Переход к agentic-нагрузке меняет то, что должен отдавать data layer. Сравнение на уровне workload:
| Измерение | Традиционная real-time аналитика | Agentic-аналитика |
|---|---|---|
| Основные потребители | Аналитики, операции, бизнес-команды | Агенты, AI-приложения, автоматические workflow |
| Базовое требование | Показать бизнес-факты | Непрерывно получать факты и контекст по всей цепочке рассуждения |
| Главные типы запросов | SQL, агрегация, фильтрация, drill-down | SQL + Vector + Full-text + Graph + Stream |
| Требования к задержке | Минуты и секунды | Секунды и доли секунды |
| Роль системы | Аналитика и поддержка решений | Точка входа фактов для понимания, рассуждения, памяти и действия |
Запросы агента — это прежде всего аналитические запросы
На уровне запроса картина яснее. Возьмём вопрос про инцидент из начала:
Найди инциденты за последние две недели, связанные с отказами GPU, из-за которых потеря выручки превысила $1M, и включи похожие исторические случаи.
Разложим его по возможности, которая нужна каждому фрагменту:
| Фрагмент запроса | Какая возможность нужна |
|---|---|
| Связано с отказом GPU | Полнотекстовый поиск, совпадение по ключевым словам |
| Последние две недели | Фильтр по времени, ограничение окна |
| Потеря выручки больше $1M | Агрегация, фильтр по метрике |
| Инциденты | Доступ к структурированным данным |
| Похожие исторические случаи | Векторный retrieval, семантическая близость |
На практике запрос, который агент генерирует к data layer, выглядит так:
SELECT *
FROM incidents
WHERE l2_distance(description_embedding, query_embedding) < 0.1
AND MATCH(log_text, 'GPU overheating')
AND severity >= 4
AND revenue_impact > 1000000
ORDER BY timestamp DESC LIMIT 10;
Структурированные фильтры и агрегация выполняются первыми. Векторное сходство — один из нескольких предикатов. Качество результата зависит от сложной фильтрации и агрегации по свежим данным при большом числе одновременных запросов, а семантический поиск встроен в тот же движок.
Отдельный векторный retrieval закрывает часть этого и оставляет остальное другим системам:
| Ключевое требование агента | Где отдельный векторный retrieval не дотягивает | Где движок real-time аналитики подходит лучше |
|---|---|---|
| Сложная фильтрация и агрегация | Опирается на внешние аналитические системы, чтобы закрыть пробел | Базовая возможность аналитического движка |
| Бизнес-факты в реальном времени | Длинный путь синхронизации, свежесть труднее гарантировать | Рядом с потреблением данных в реальном времени |
| Короткие запросы при большом числе одновременных обращений | Лучше подходит для поиска похожих, не рассчитан на сложную аналитическую нагрузку | Лучше выдерживает большой объём аналитических вызовов инструментов |
| Интерпретируемость результата | Часто нужно отдельно прикладывать структурированные данные | Возвращает проверяемые бизнес-факты напрямую |
Как Apache Doris соединяет традиционную и agentic-аналитику
Apache Doris начали строить десять лет назад как базу для real-time поиска и аналитики: много одновременных запросов и низкая задержка на больших объёмах. Тогда систему не строили под AI-агентов, но те же архитектурные решения для real-time аналитики теперь совпадают с тем, чего требует нагрузка агентов.
Чтобы обслуживать эту нагрузку напрямую, Doris добавил hybrid search в движок real-time аналитики: нативный векторный поиск и полнотекстовый поиск в одной системе. Агенты получают real-time производительность Doris и hybrid search, который нужен их запросам, из одного движка.
Те же базовые возможности переходят из аналитики к агентам:
| Базовая возможность Apache Doris | Ценность в традиционной аналитике | Расширенная ценность в нагрузке агентов |
|---|---|---|
| Real-time ingestion и обновления | Последние заказы, транзакции и метрики доступны сразу | Агенты рассуждают на самых свежих бизнес-фактах |
| OLAP с низкой задержкой | Обслуживает отчёты, дашборды и ad-hoc запросы | Обслуживает частые вызовы инструментов по всей цепочке рассуждения |
| Запросы с большим числом одновременных обращений | Обслуживает много аналитиков и бизнес-приложений | Обслуживает сотни и тысячи агентов и автоматических workflow |
| Полуструктурированная обработка | Работает с JSON, Variant и другими гибкими форматами | Принимает результаты инструментов, payload событий и структуры, которые породил AI |
| Lakehouse и единый доступ к нескольким источникам | Собирает данные из разных источников | Холодные справочные данные и горячие факты проще читать вместе |
| Объединение полнотекстового и векторного поиска | Расширяет границу аналитики | Приближает hybrid search к одной точке входа |
Мультимодальный контекст: единый слой контекста
Если отойти от одного запроса, видна вторая потребность. Команды часто относят мультимодальные данные к отдельной категории, не к аналитике, будто векторы и графы знаний живут на другом ярусе, чем OLAP. Ценность мультимодальных данных проявляется, когда их используют рядом со структурированными: так аналитика приближается к живым бизнес-операциям.
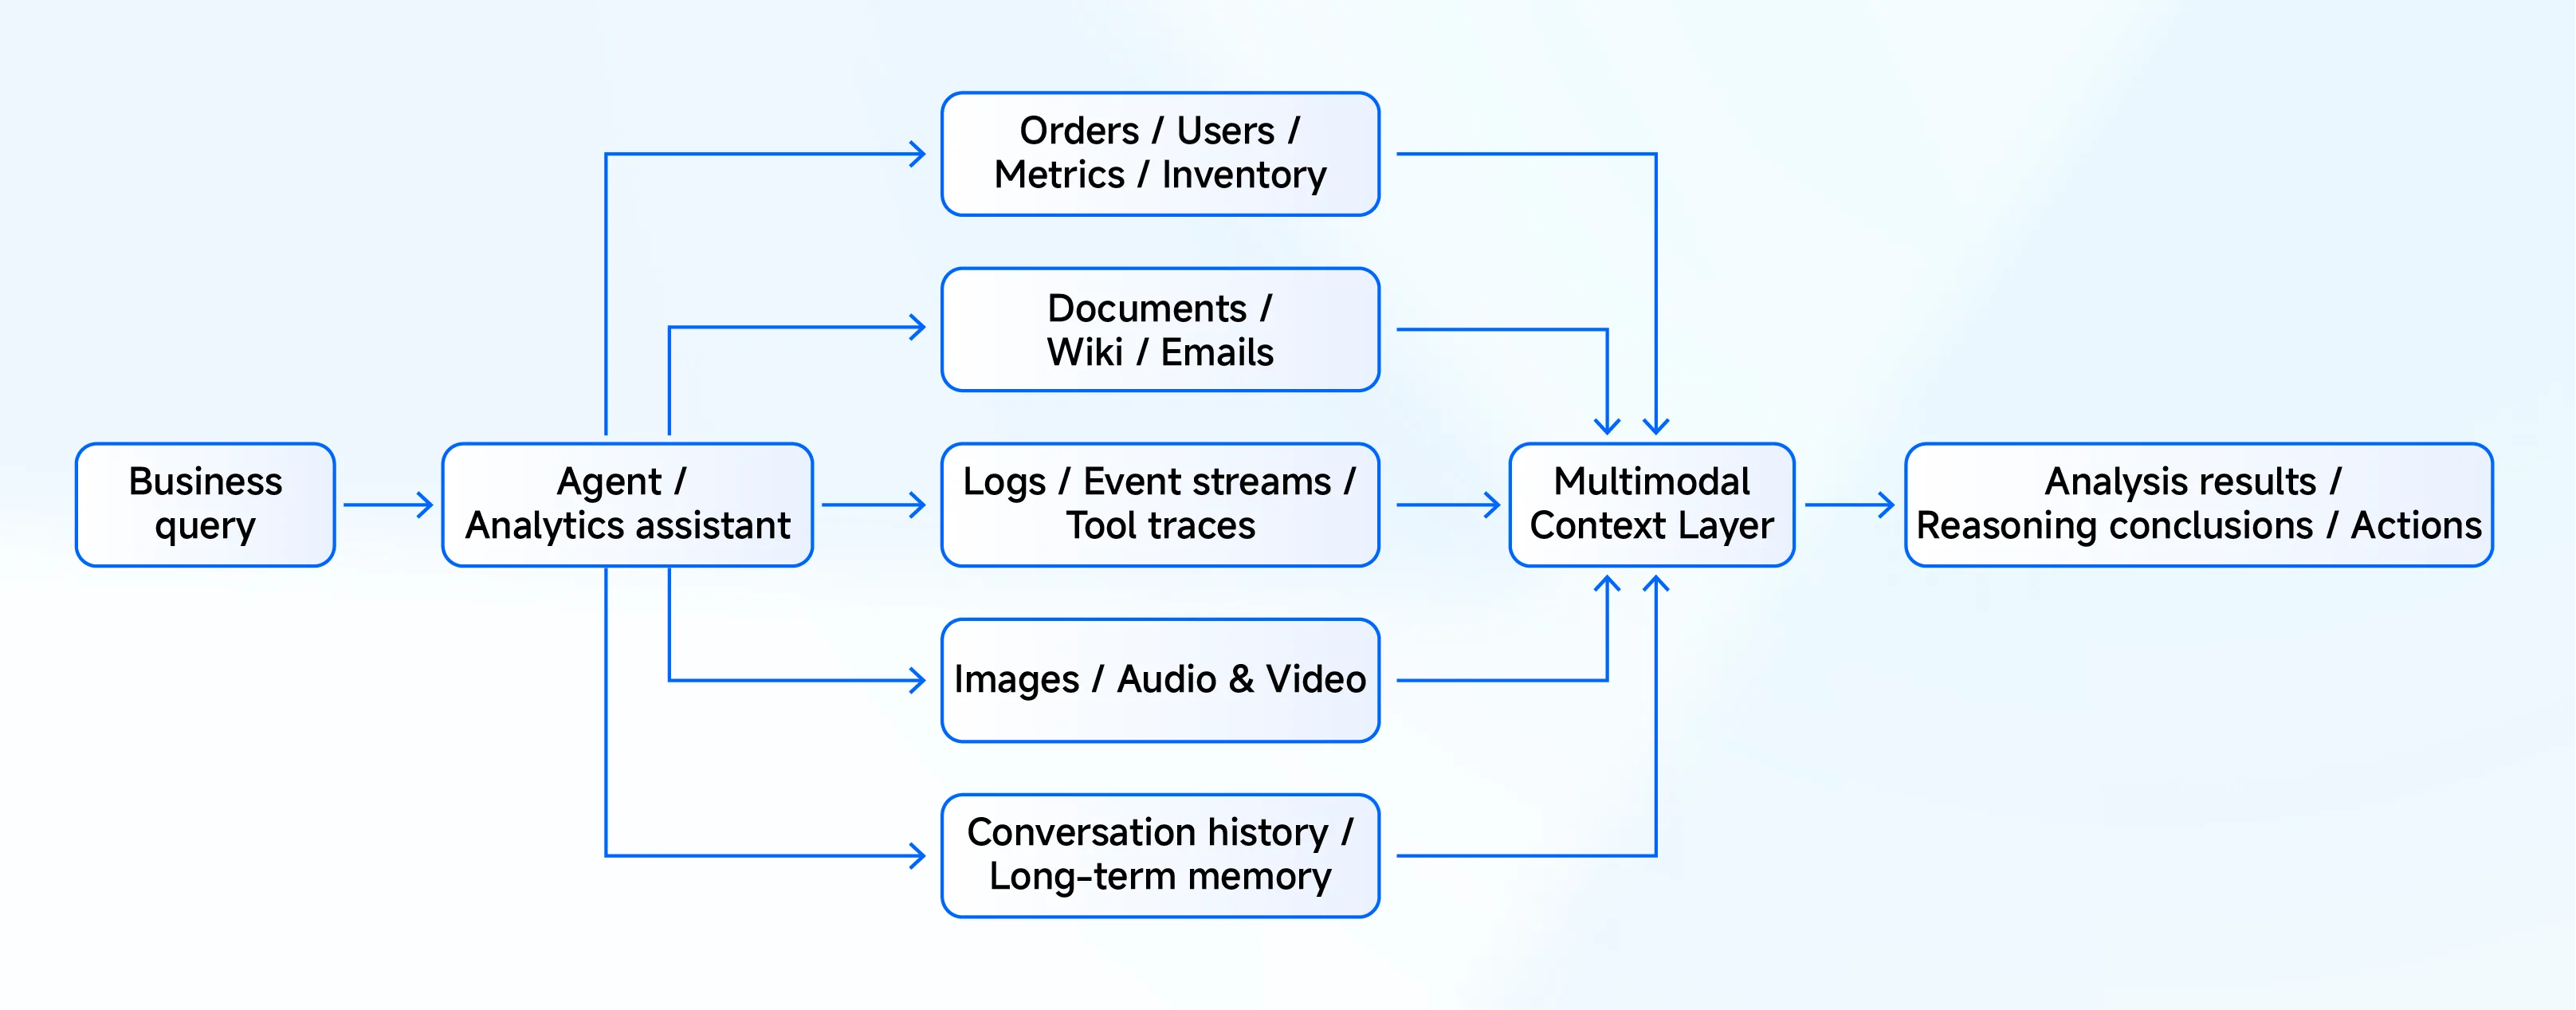
Структурированные данные дают агентам фактическую основу, а полуструктурированные данные дают моделям информацию, чтобы понять, объяснить и действовать. Это и называют контекстом. Ops-агенту нужно знать, перешла ли потеря выручки порог: это факт. И ему нужны связанные fault-логи, похожие прошлые инциденты и runbook: это контекст. И факт, и контекст нужны, чтобы собрать связный и точный ответ или действие.
Мультимодальный контекст — это не только поддержка большего числа типов данных. Это единый слой контекста, который агенты могут надёжно потреблять: факты, объяснения, поведение, память и семантика внутри одной системы. Такая роль толкает движок real-time аналитики вроде Doris вырасти из системы поиска и аналитики в систему контекста.
Так устроены слои контекста:
| Слой данных | Типичное содержимое | Роль для агента | Зачем соединять с аналитикой |
|---|---|---|---|
| Слой фактов | Заказы, транзакции, метрики, остатки, инциденты | Отвечает «что произошло» | Нужны фильтрация, агрегация, join и запросы в реальном времени |
| Слой объяснений | Документы, тикеты, письма, комментарии, базы знаний | Отвечает «почему это произошло» | Должен возвращаться рядом с фактическим результатом |
| Слой поведения | Логи, потоки событий, трассы вызовов инструментов | Отвечает «как разворачивалась последовательность» | Нужны join по времени и по сущности |
| Слой памяти | Профили пользователей, история диалога, состояние задачи | Отвечает «что было раньше и что дальше» | Нужны непрерывные обновления, встроенные в текущий запрос |
| Семантический слой | Embeddings, связи сущностей, графы знаний | Отвечает «что с чем связано» | Должен работать рядом со структурированной фильтрацией и аналитикой |
Почему набор отдельных баз ломается на нагрузке агентов
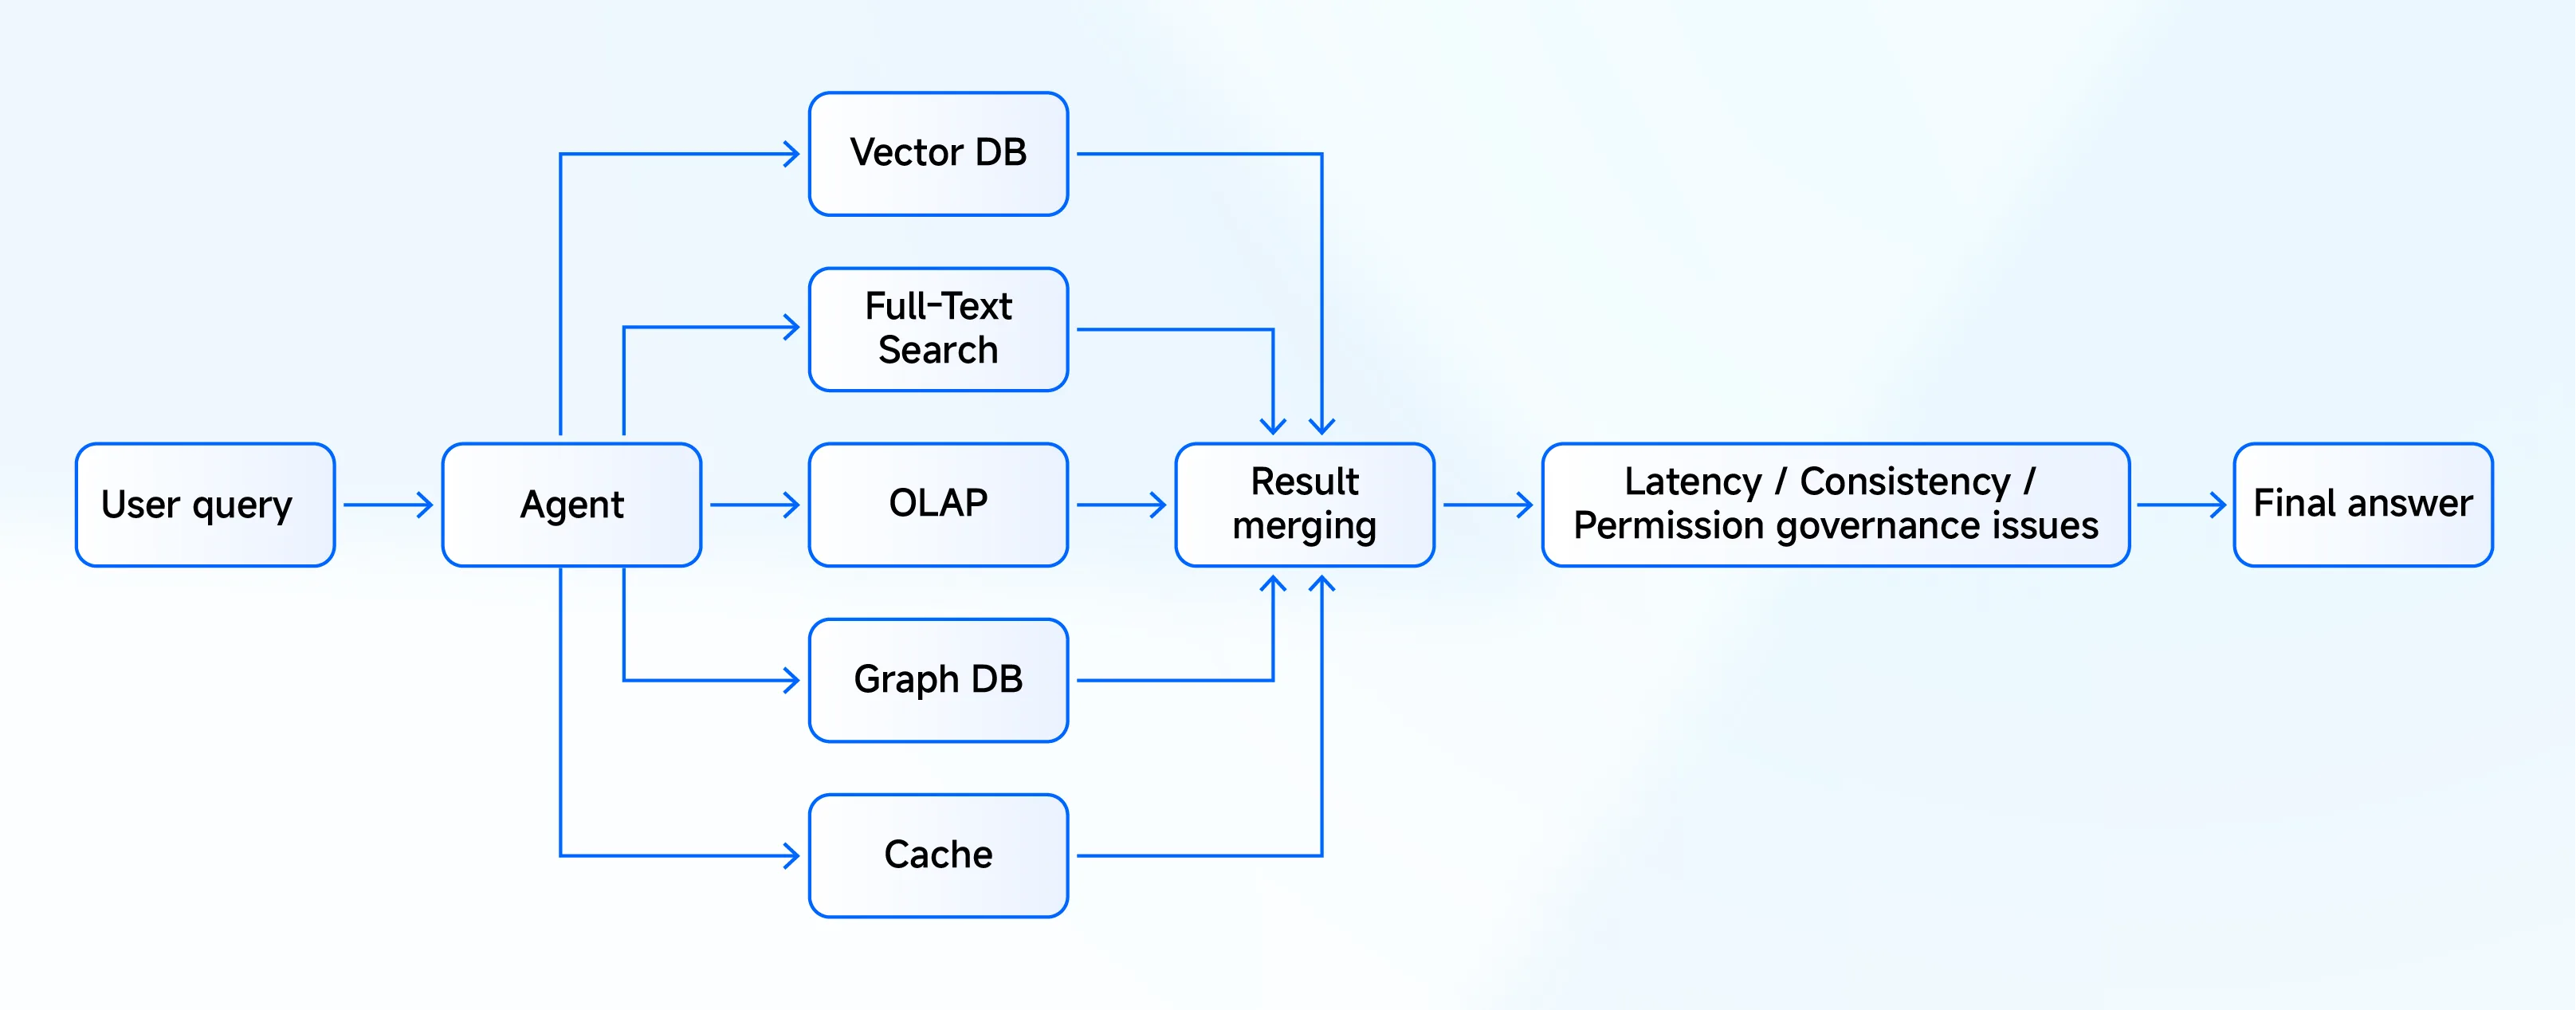
Большинство корпоративных стеков собирает этот контекст из отдельных систем: vector store для embeddings, поисковый движок для полнотекстового поиска, OLAP для агрегаций и отдельное хранилище для полуструктурированных данных. Человек-оператор закрывает разрывы между ними вручную. У агента такого моста нет.
Агентам нужен максимально короткий путь к данным. Когда одна задача прыгает по нескольким backend, складываются три проблемы:
- Фрагментация контекста: данные есть, но агент видит куски, а не целую картину.
- Дрейф согласованности: у каждой системы свой ритм синхронизации, обновления индекса и модель прав, и каждый зазор ухудшает рассуждение.
- Задержка и стоимость: один логический запрос расходится в несколько сетевых вызовов и раундов склейки результатов, и цепочка замедляется или рвётся.
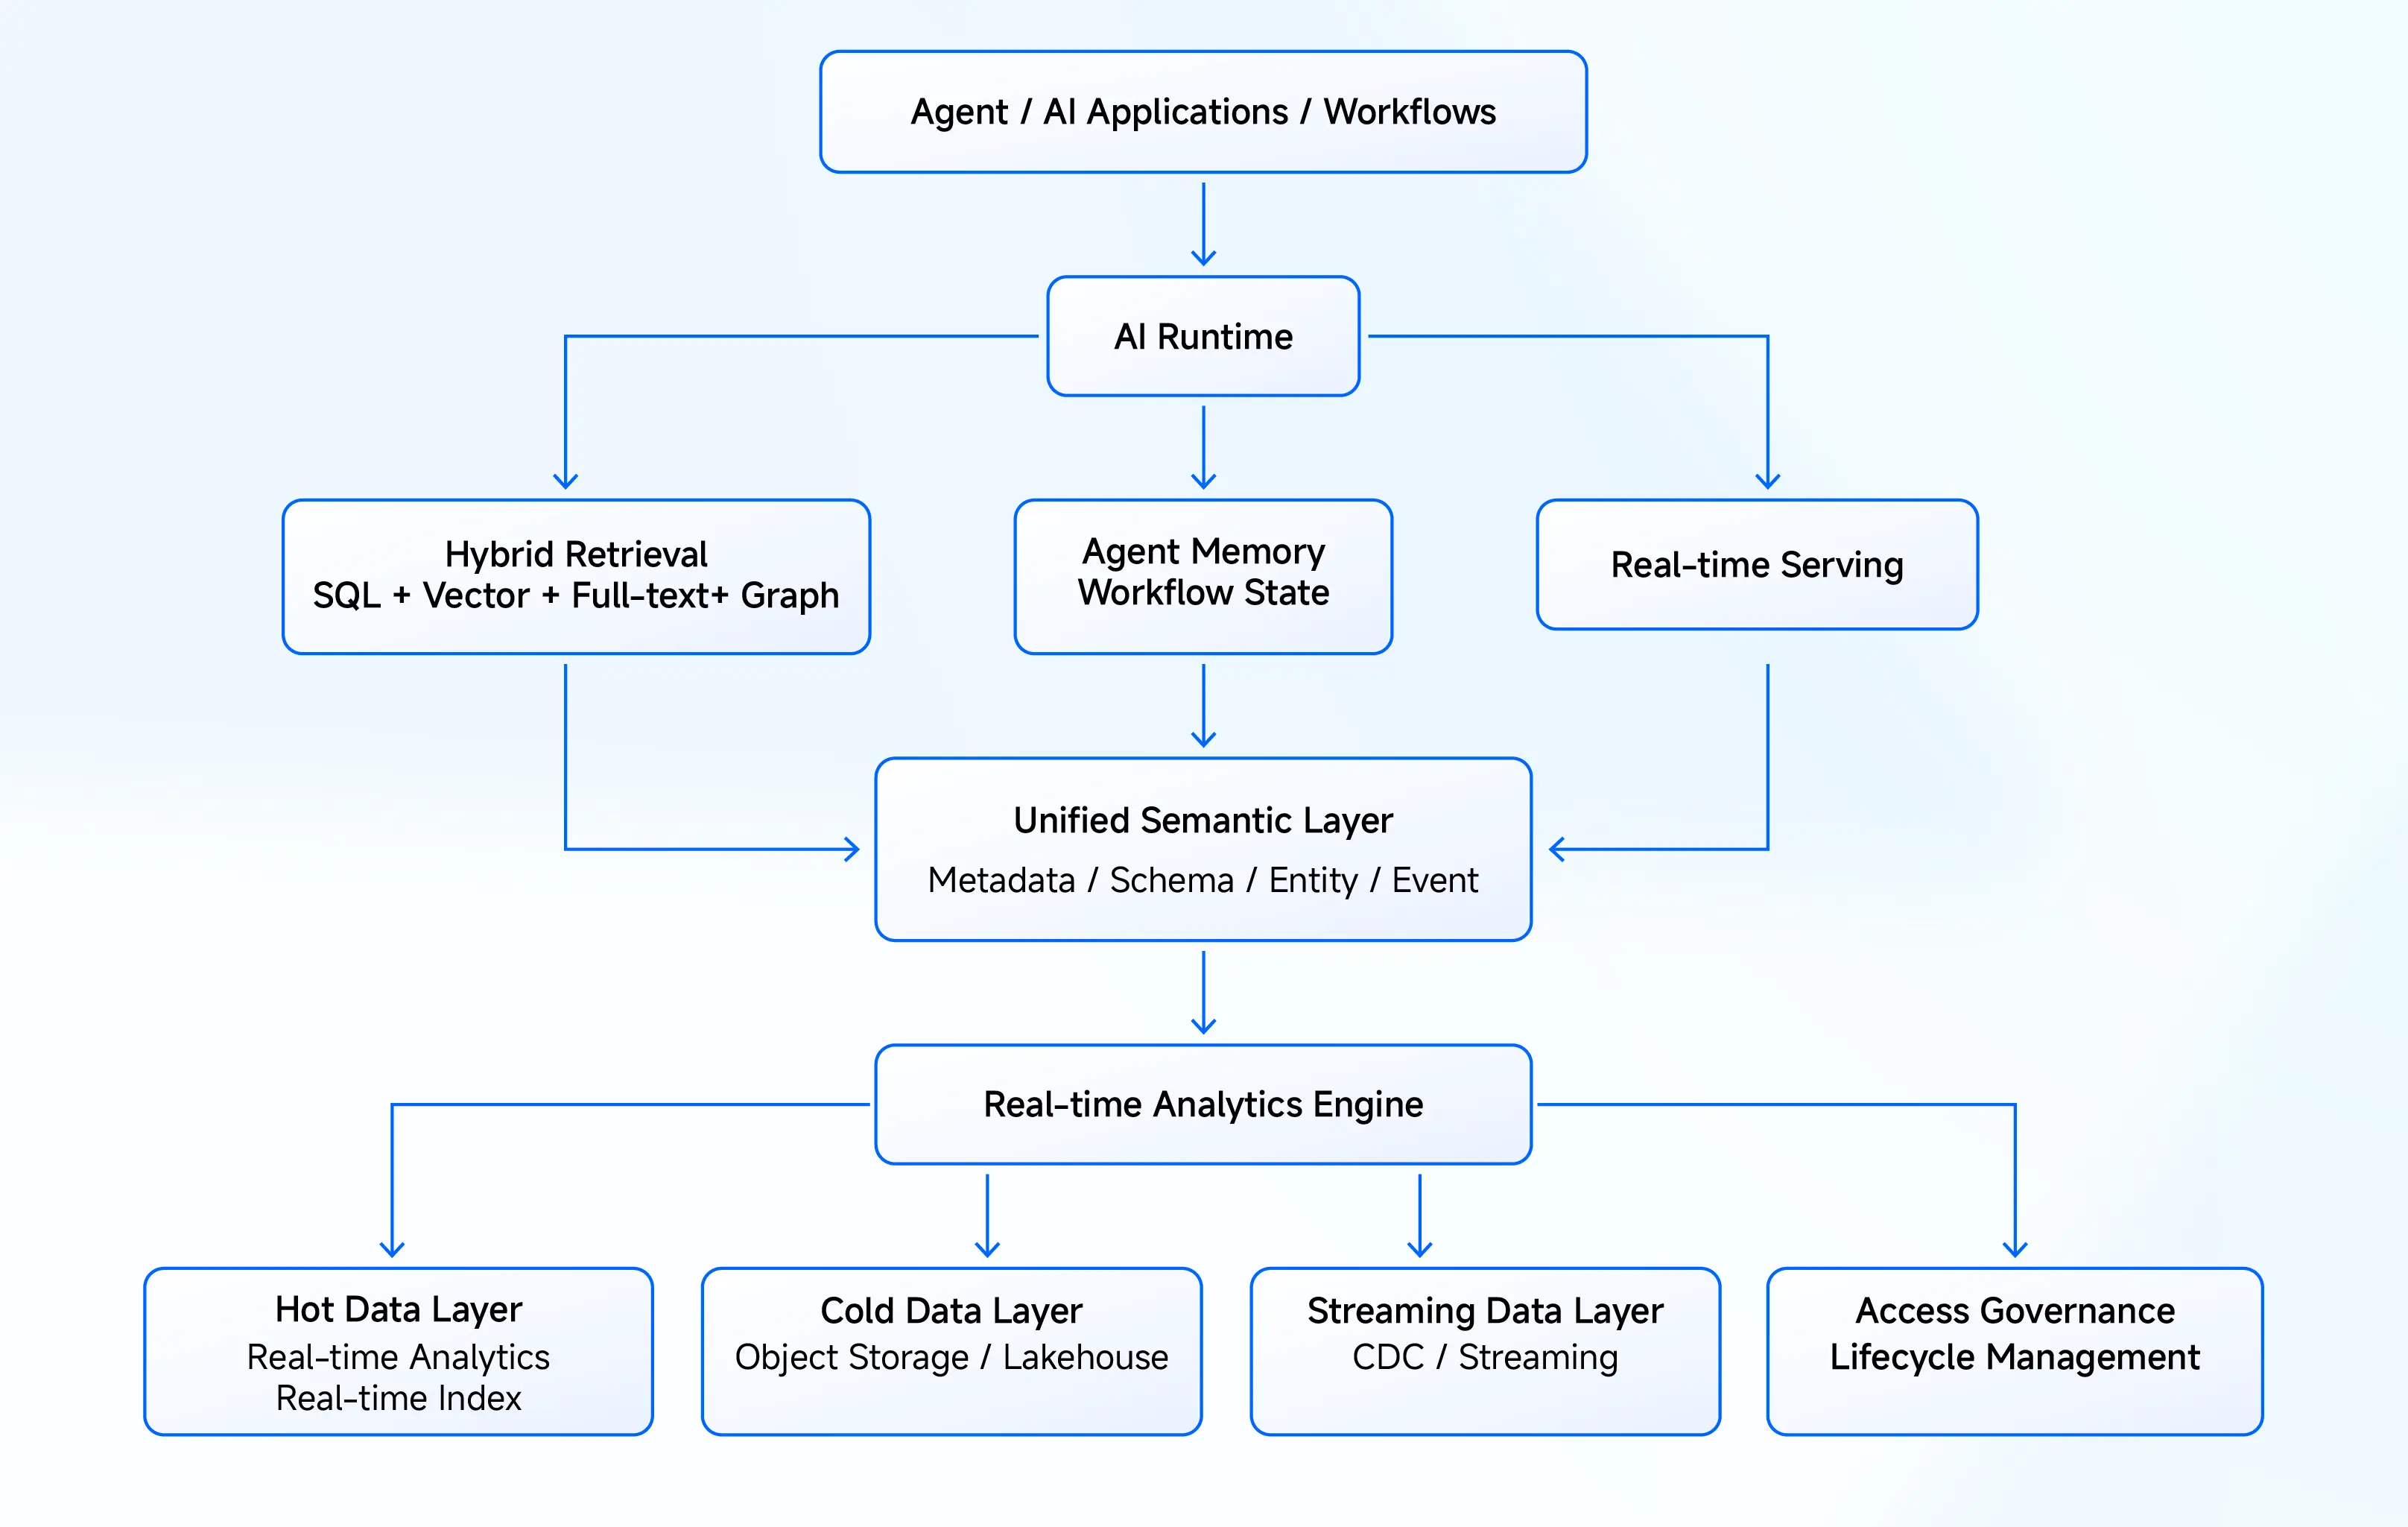
Поэтому в Doris добавили нативный полнотекстовый поиск и векторный поиск: один движок для полнотекстового поиска, векторного поиска и полуструктурированных данных. Путь к данным для агентов становится короче и устойчивее.
Внутри этого единого движка Doris берёт на себя retrieval контекста, планирование hybrid-запроса и память агента рядом с аналитической работой. Расширяться от зрелого движка real-time аналитики практичнее, чем сшивать специализированные системы снаружи.
Вот что заменяет один единый движок:
| Модуль | Раньше его давала | Единый real-time движок |
|---|---|---|
| OLAP | Хранилище данных / аналитическая БД | Получение фактов в реальном времени и агрегация |
| Полнотекстовый поиск | Поисковый движок | Поиск по ключевым словам и выдача доказательств |
| Векторный поиск | Vector DB | Семантическая близость и релевантность |
| Streaming | Kafka / Apache Flink | События в реальном времени и инкрементальные обновления |
| Полуструктурированная обработка | Движок JSON / Variant | Гибкие входы и данные инструментов |
| Хранилище памяти | Session / Agent Store | Долгая память и состояние задачи |
| Семантический слой | Система метаданных / governance | Данные стабильно читаются машиной |
Итог
Production AI-агенты — прежде всего потребители аналитики. Запросы, которые они генерируют, за один шаг покрывают структурированные данные, полнотекстовый поиск и векторный retrieval, и ответы им нужны в реальном времени, а не из пакетной синхронизации.
Apache Doris соединяет real-time аналитику с нативным hybrid search в одном движке и даёт production-агентам единый путь к данным через структурированные, полуструктурированные и векторные данные.
Источник оригинала
Matt Yi, Apache Doris PMC Member и Tech VP @ VeloDB, «Why AI Agents Need Real-Time Analytics and Hybrid Search», 2026-06-24.
https://www.velodb.io/blog/why-ai-agents-need-real-time-analytics-and-hybrid-search